Eigene Modelle, eigene Datenextraktion: die KI-Architektur hinter OPAN®
Neu lässt sich in OPAN® die Datenextraktion aktivieren. Ist sie eingeschaltet, entscheidet die anmeldende Person pro Anmeldung, ob sie sie einsetzt: Sie lädt den Austrittsbericht hoch und startet die Extraktion.
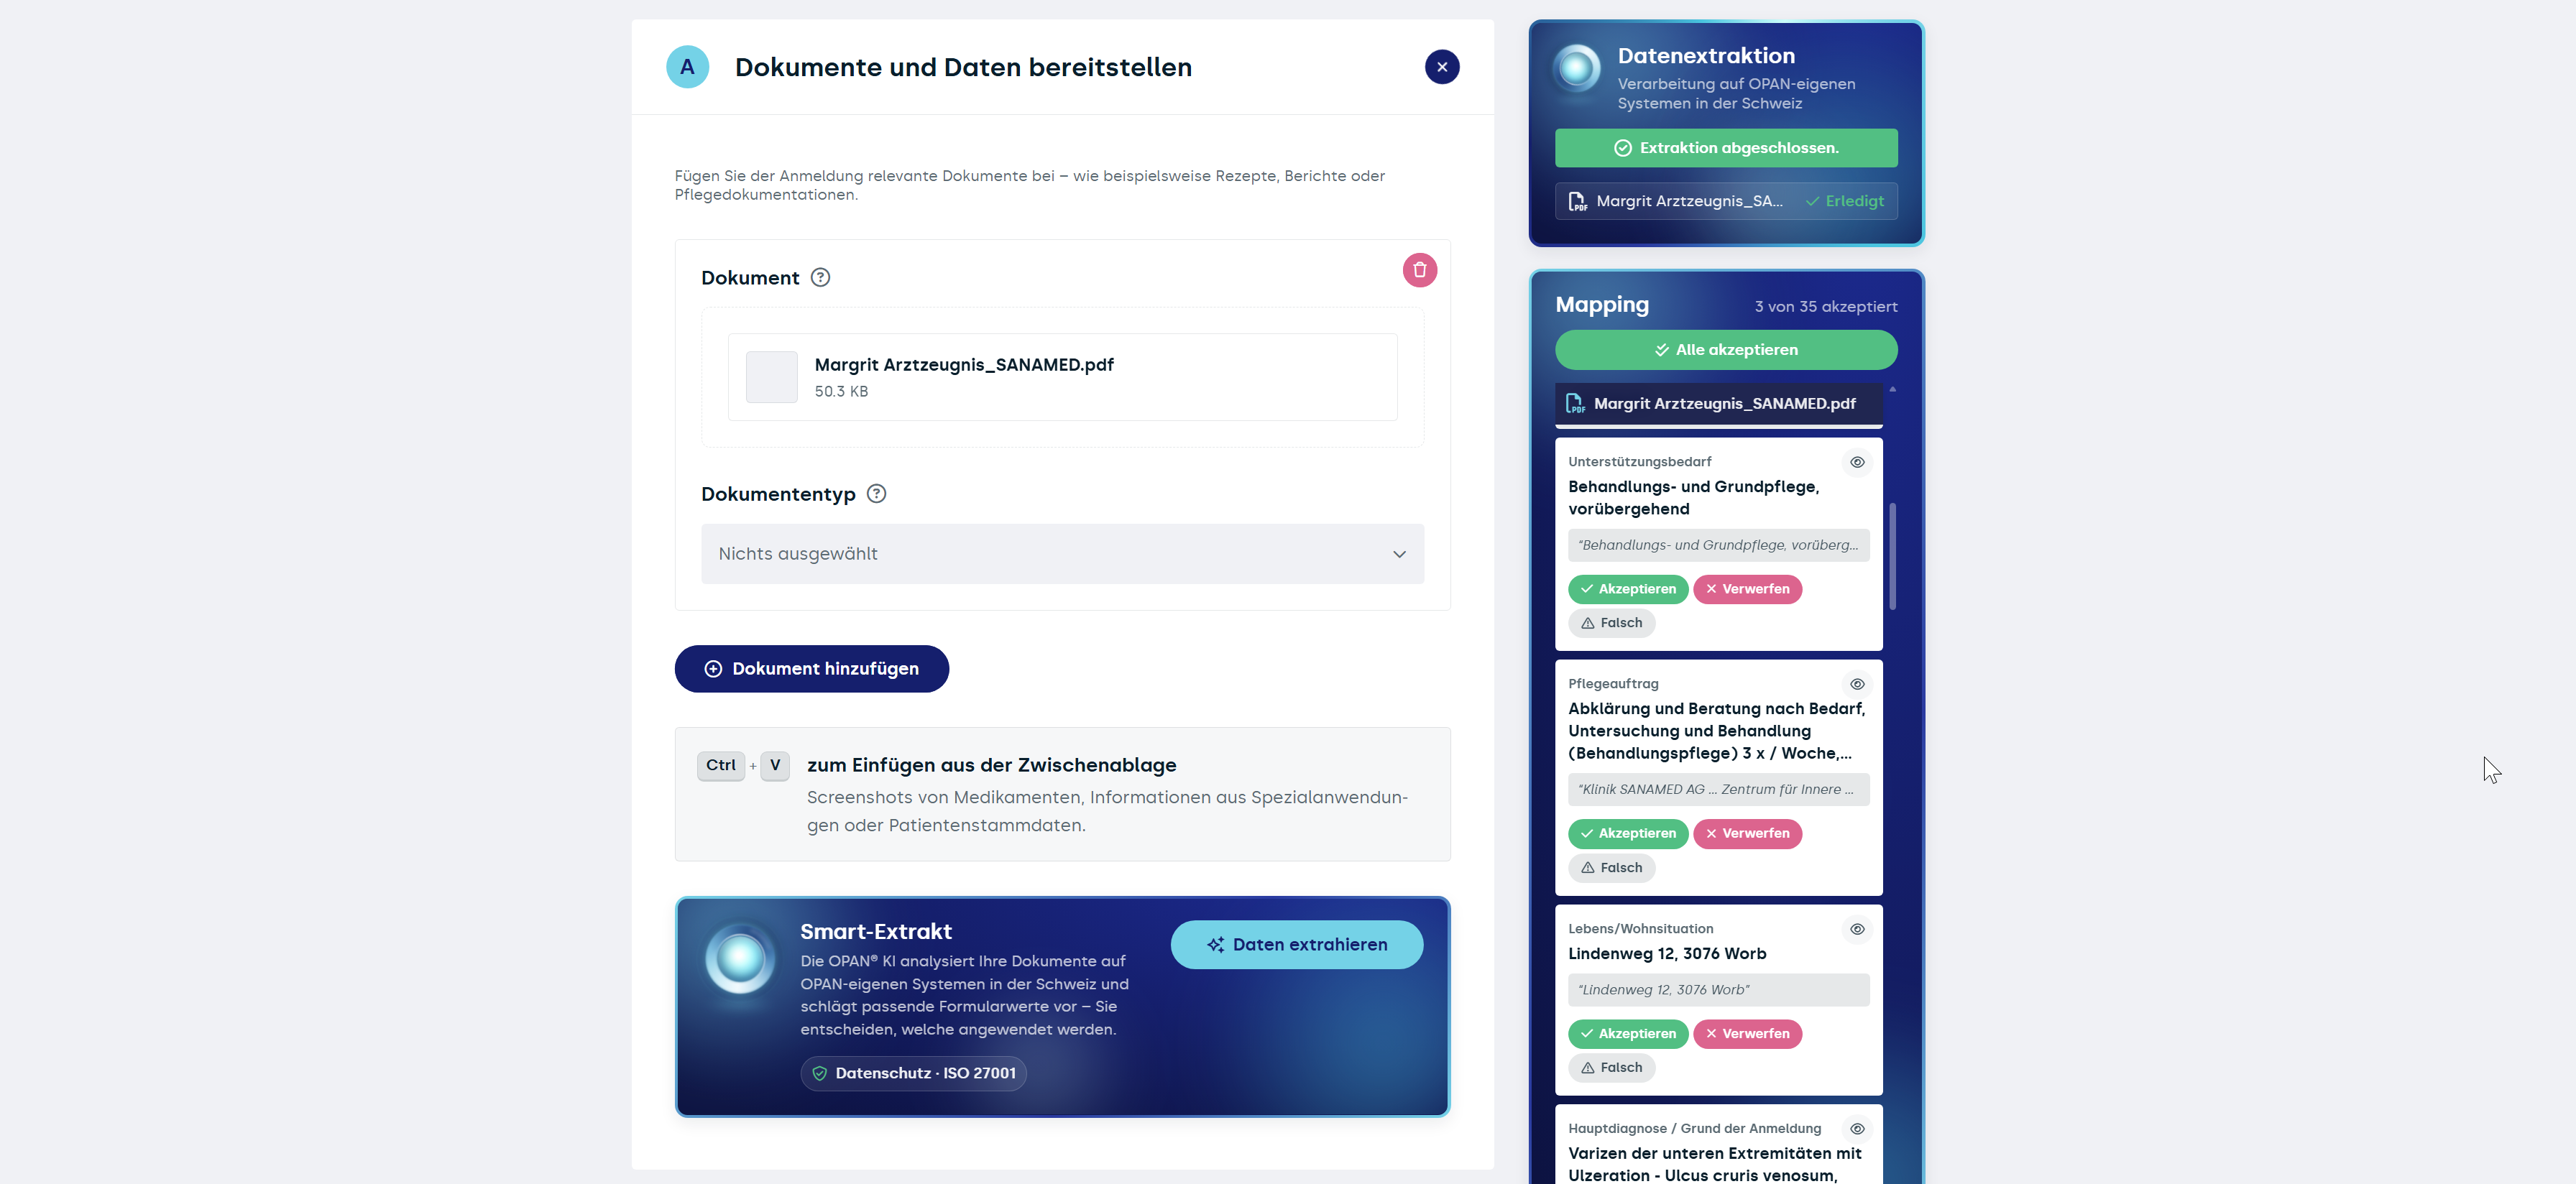
Die Extraktion liest das Dokument aus, erkennt die Angaben, die für die Anmeldung gebraucht werden, und überträgt sie in die passenden Felder des Formulars.
Das hebt die Datenqualität gleich doppelt. Angaben, die sonst von Hand abgetippt werden, kommen direkt aus der Quelle. Und was im Dokument fehlt, wird im Formular als Lücke sichtbar, bevor die Anmeldung an den Leistungserbringer geht.
Die Kontrolle bleibt damit an zwei Stellen bei der anmeldenden Person, beim Auslösen und beim Freigeben. Extrahierte Werte sind Vorschläge: Sie stehen im Formular, werden geprüft, bei Bedarf korrigiert und erst dann freigegeben. Die Verarbeitung nimmt Arbeit ab, nicht die Verantwortung.
Pro Eingangsformat eine Pipeline
Am Anfang steht nicht ein Modell, sondern eine Aufteilung nach Herkunft der Daten. Dokumenten-Uploads und per API übermittelte Dokumente gehen in den Dokument-Processor, Screenshots vorher durch den Image-Processor. Strukturierte Lieferungen aus UPI, API und FHIR nimmt der JSON-Processor auf; für Zuweiser mit eigenem Feldschema kommt ein Custom Mapper dazu.
Diese Trennung ist Absicht. Ein Screenshot braucht Bildverarbeitung, ein FHIR-Bundle nicht. Wer beides durch dieselbe Verarbeitung schickt, verliert entweder Präzision beim strukturierten Fall oder Robustheit beim unstrukturierten.
Das Daten-Super-Set
Alle Pipelines münden in denselben Schritt: Extraktion gegen definierte Schemata und Regeln, ausgeführt von austauschbaren Modellen und Agenten. Das Ergebnis nennen wir intern das Daten-Super-Set, den maximal strukturierten Stand eines Falls.
Die Fachlogik liegt dabei in den Schemata und Regeln, nicht im Modell. Welche Angaben eine Spitex-Anmeldung braucht und welche eine Reha-Anfrage, ist versorgungsspezifisches Wissen und gehört nicht in Modellgewichte. Das erlaubt uns, ein Modell gegen ein besseres zu tauschen, ohne die Extraktionsregeln neu zu schreiben.
Dazu kommen dritte Anreicherungs- und Plausibilisierungsdienste: VEKA-Abfragen, HIN-Verzeichnisse, Geokoordinaten, Normalisierung von Adressen und Bezeichnungen. Ein Teil der Datenqualität entsteht nicht durch Sprachmodelle, sondern durch den Abgleich mit verlässlichen Registern.
Was auf dem strukturierten Fall aufsetzt
Aus einem strukturierten Fall lassen sich Funktionen bauen, die auf Freitext nicht zuverlässig laufen. In Entwicklung sind bei uns die KI-Fallzusammenfassung, eine Plausibilitäts- und Vollständigkeitsprüfung vor dem Absenden, ein Fall-Chat, Dokumentenübersetzungen und KI-gestützte Auswertungen. Diese Funktionen rollen wir graduell aus, ein Teil davon in einer Beta-Phase mit ausgewählten Kunden.
Der zweite Weg ist wichtiger, als er auf den ersten Blick aussieht: Leistungserbringer können die strukturierten Daten über die API abholen und in ihrer eigenen Umgebung weiterverarbeiten. Wer selbst KI betreibt, für Triage, Reporting oder Vorbefüllung im eigenen System, erhält von uns eine saubere Datengrundlage statt einer weiteren Oberfläche. OPAN® muss nicht der Ort sein, an dem jede KI-Verarbeitung stattfindet.
Eigene GPU, Schweizer Hosting, eigene Pipelines
Wir betreiben die KI-Verarbeitung auf eigenen GPU-Servern in der Schweiz, mit lokal gehosteten Sprachmodellen ohne Internetzugang. Das ist eine Datenschutzentscheidung, bevor es eine technische ist. In einer Anmeldung stehen besonders schützenswerte Personendaten. Sobald diese an einen externen Modellanbieter gehen, hängen Auftragsbearbeitung, Ort der Verarbeitung und Zweckbindung an dessen Bedingungen. Zur technischen Seite kommt die organisatorische: OPAN CARE AG ist nach ISO 27001 zertifiziert.
Der Preis dieser Entscheidung ist Aufwand. Pipelines, Extraktionsschemata und Betrieb entwickeln wir selbst; wir konsumieren keine fertige KI-Suite. Dafür können wir die Verarbeitung auf den Zuweisungsprozess ausrichten statt auf einen allgemeinen Anwendungsfall, und wir bestimmen selbst, welches Modell wann zum Einsatz kommt.
Beta-Phase: Datenextraktion jetzt testen
Besonders tragfähig wird die Verarbeitung, wenn beide Wege zusammenkommen. Über die Schnittstelle kommen die Stammdaten aus dem KIS ins Formular. Aus den mitgelieferten Dokumenten holt die Extraktion den Kontext dazu, also die Angaben zu Verlauf und Bedarf, für die es kein Schnittstellenfeld gibt, und setzt sie ebenfalls sauber in die vorgesehenen Felder.
Wo sich beide Quellen überschneiden, werden dieselben Angaben doppelt geprüft. Wo die Schnittstelle nichts liefert, ergänzt das Dokument.
Sind Sie bereits OPAN-Kunde und möchten an der Beta-Phase teilnehmen, melden Sie sich bei uns. Die Funktionen sind bereit, wir rollen sie graduell aus.
Möchten Sie uns von OPAN® kennenlernen?
Besuchen Sie uns vom 20. bis 22. Oktober 2026 an der IFAS in der Halle 7, Stand E44, nehmen Sie mit uns Kontakt auf oder melden Sie sich gleich an für den Presentation Cube: OPAN® Search4Care in der Halle 5 (Mittwoch, 21. Oktober 2026, von 9.30 bis 10.30 Uhr, die Plätze sind begrenzt): ifas.opancare.ch