Nos propres modèles, notre propre extraction de données : l’architecture d’IA d’OPAN®
L’extraction de données peut désormais être activée dans OPAN®. Lorsqu’elle est activée, la personne qui effectue l’inscription décide, pour chaque inscription, si elle l’utilise : elle téléverse le rapport de sortie et lance l’extraction.
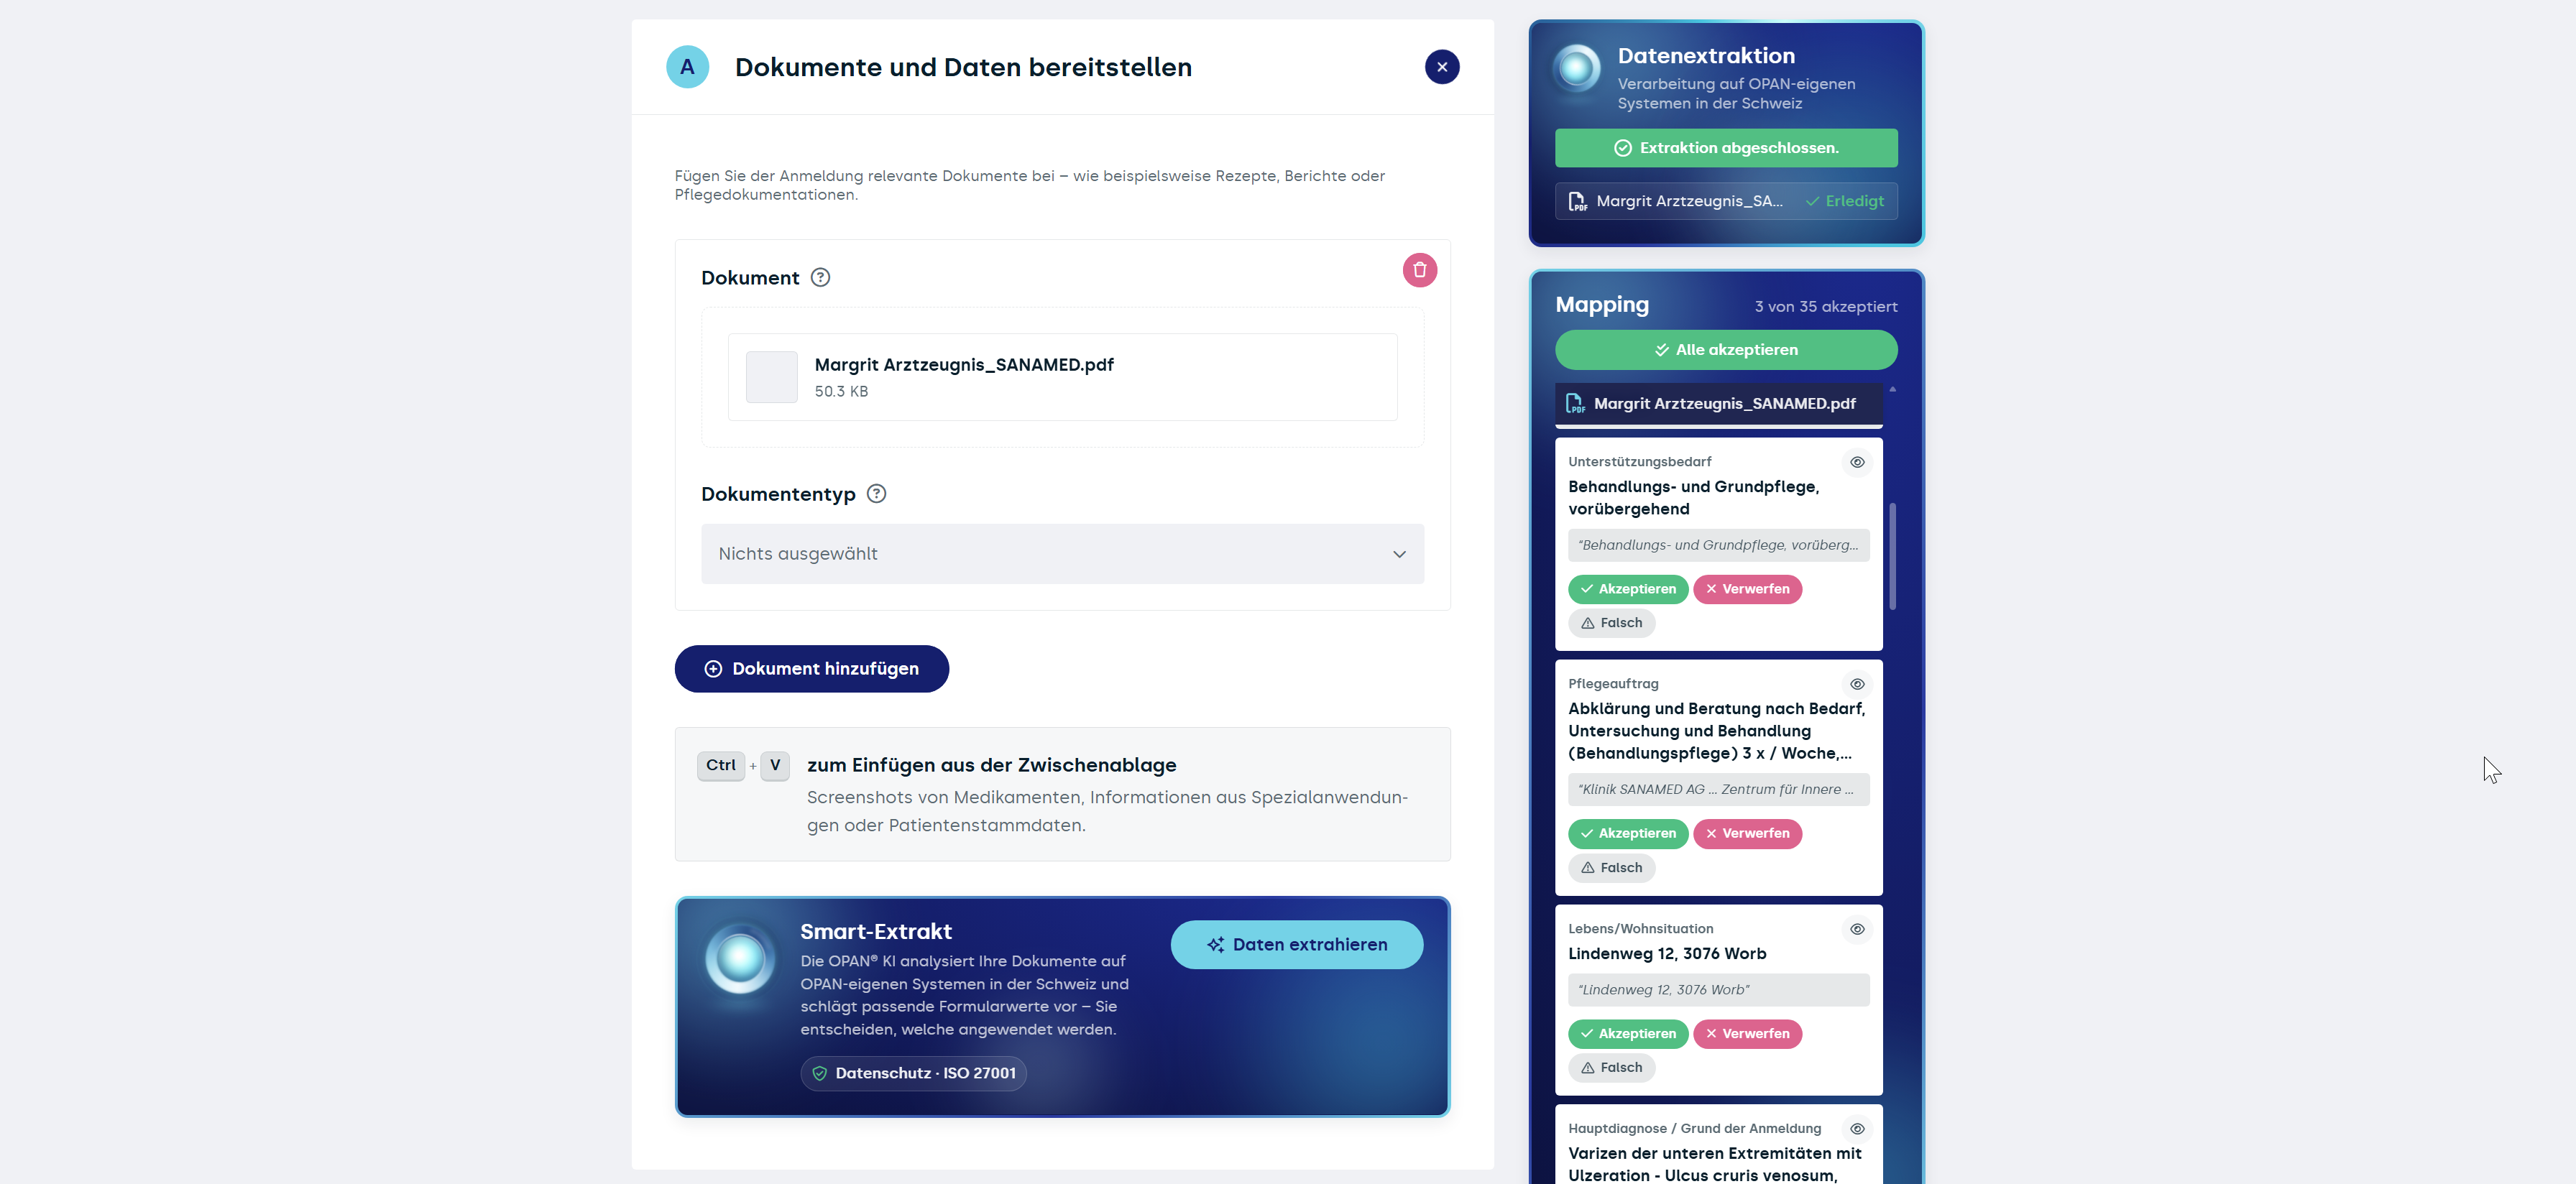
L'extraction lit le document, identifie les informations nécessaires à l’inscription et les reporte dans les champs correspondants du formulaire.
La qualité des données s’en trouve doublement améliorée. Les informations habituellement saisies à la main proviennent directement de la source. Et ce qui manque dans le document apparaît comme une lacune dans le formulaire, avant que l’inscription ne soit transmise au prestataire de services.
La personne qui effectue l’inscription garde ainsi le contrôle à deux moments : au lancement et à la validation. Les valeurs extraites sont des propositions : elles figurent dans le formulaire, sont vérifiées, corrigées si nécessaire, et seulement ensuite validées. Le traitement allège le travail, pas la responsabilité.
Un pipeline par format d’entrée
Au départ, il n’y a pas un modèle, mais une répartition selon la provenance des données. Les documents téléversés et ceux transmis via l’API passent par le processeur de documents ; les captures d’écran passent d’abord par le processeur d’images. Les livraisons structurées issues de l’UPI, de l’API et de FHIR sont prises en charge par le processeur JSON ; pour les établissements d’envoi qui utilisent leur propre schéma de champs, un mapper personnalisé s’y ajoute.
Cette séparation est voulue. Une capture d’écran nécessite un traitement d’image, un bundle FHIR non. Traiter les deux de la même manière, c’est perdre soit en précision pour le cas structuré, soit en robustesse pour le cas non structuré.
Le super-ensemble de données
Tous les pipelines aboutissent à la même étape : une extraction selon des schémas et des règles définis, exécutée par des modèles et des agents interchangeables. Nous appelons le résultat, en interne, le super-ensemble de données : l’état le plus structuré possible d’un cas.
La logique métier réside dans les schémas et les règles, pas dans le modèle. Les informations nécessaires à une inscription auprès de l’aide et soins à domicile ou à une demande de réadaptation relèvent d’un savoir propre à chaque type de prise en charge. Ce savoir n’a pas sa place dans les poids d’un modèle. Nous pouvons ainsi remplacer un modèle par un meilleur sans réécrire les règles d’extraction.
S’y ajoutent des services tiers d’enrichissement et de contrôle de plausibilité : requêtes VEKA, annuaires HIN, coordonnées géographiques, normalisation des adresses et des désignations. Une partie de la qualité des données ne provient pas des modèles de langage, mais de la comparaison avec des registres fiables.
Ce qui s’appuie sur le cas structuré
Un cas structuré permet de développer des fonctions qui ne fonctionnent pas de manière fiable sur du texte libre. Nous développons actuellement la synthèse de cas par IA, un contrôle de plausibilité et d’exhaustivité avant l’envoi, un chat de cas, la traduction de documents et des analyses assistées par IA. Nous déployons ces fonctions progressivement, certaines dans le cadre d’une phase bêta avec des clients sélectionnés.
La seconde voie est plus importante qu’il n’y paraît : les prestataires de services peuvent récupérer les données structurées via l’API et les traiter dans leur propre environnement. Les organisations qui exploitent elles-mêmes de l’IA, pour le triage, le reporting ou le préremplissage dans leur propre système, reçoivent de notre part des données propres et structurées plutôt qu’un écran de plus. OPAN® n’a pas besoin d’être l’endroit où se déroule chaque traitement par IA.
Nos propres GPU, un hébergement en Suisse, nos propres pipelines
Nous exploitons le traitement par IA sur nos propres serveurs GPU en Suisse, avec des modèles de langage hébergés localement et sans accès à Internet. C’est une décision de protection des données avant d’être une décision technique. Une inscription contient des données personnelles sensibles. Dès que ces données sont transmises à un fournisseur de modèles externe, la sous-traitance, le lieu du traitement et le principe de finalité dépendent des conditions de ce fournisseur. Au volet technique s’ajoute le volet organisationnel : OPAN CARE AG est certifiée ISO 27001.
Cette décision a un prix : l’effort. Nous développons nous-mêmes les pipelines, les schémas d’extraction et l’exploitation ; nous n’utilisons pas de suite d’IA clé en main. En contrepartie, nous pouvons orienter le traitement sur le processus d’inscription plutôt que sur un cas d’usage générique, et nous décidons nous-mêmes quel modèle est utilisé et à quel moment.
Phase bêta : testez dès maintenant l’extraction de données
Le traitement est particulièrement solide lorsque les deux voies se rejoignent. Via l’interface, les données de base issues du système d’information clinique (SIC) arrivent dans le formulaire. À partir des documents joints, l’extraction apporte le contexte, c’est-à-dire les informations sur l’évolution et les besoins pour lesquelles il n’existe aucun champ d’interface, et les reporte elles aussi proprement dans les champs prévus.
Là où les deux sources se recoupent, les mêmes informations sont vérifiées deux fois. Là où l’interface ne fournit rien, le document complète.
Votre organisation utilise déjà OPAN® et vous souhaitez participer à la phase bêta ? Contactez-nous. Les fonctions sont prêtes, nous les déployons progressivement.
Souhaitez-vous nous rencontrer chez OPAN® ?
Rendez-vous visite du 20 au 22 octobre 2026 à l'IFAS, hall 7, stand E44, contactez-nous ou inscrivez-vous dès maintenant pour le Presentation Cube : OPAN® Search4Care dans le hall 5 (mercredi 21 octobre 2026, de 9h30 à 10h30, les places sont limitées) : ifas.opancare.ch